Библиотека промптов и eval-набор для SEO-текстов (E-E-A-T)
12 шаблонов SEO + eval: черновик с чек-листом, публикация только после редактора.
eval, LLM, SEO, промпт-инжиниринг
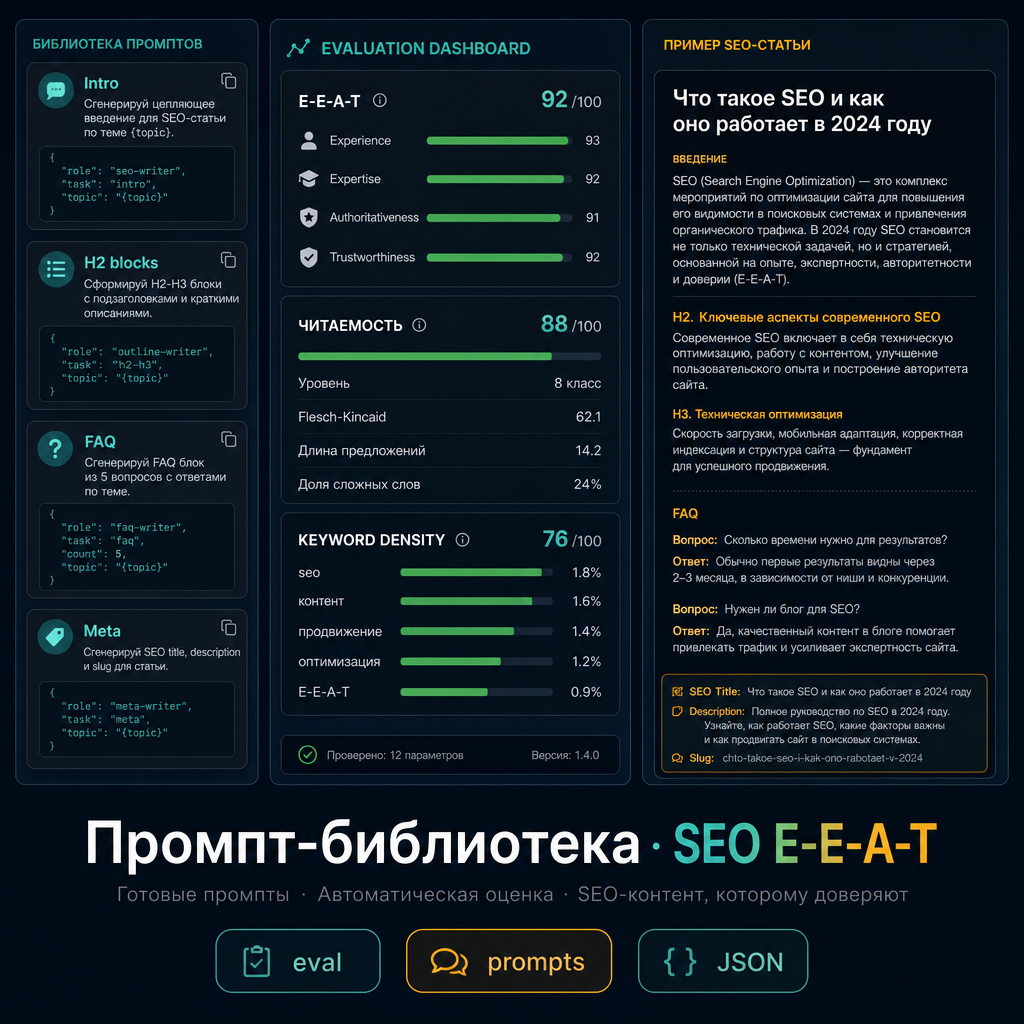
Клиент — контент-агентство, 8 SEO-редакторов и сетка сайтов (медицина, финансы, B2B). Тексты писали через «универсальный промпт в ChatGPT» — результат нестабилен: то переспам, то вода, то нарушение медицинских дисклеймеров. Редакторы тратили 40–60 минут на правку каждого черновика.
Задача: библиотека промптов под типы материалов + eval-набор для измерения качества до публикации. Не автопостинг — редактор получает черновик и чек-лист, финальное слово за человеком.
- 12 prompt-шаблонов: лендинг, статья, FAQ, обзор, comparison, news — с переменными (ниша, ключи, tone, объём);
- блок E-E-A-T в каждом промпте: экспертность, источники, disclaimer под YMYL-ниши;
- eval-набор (80 эталонных заданий): keyword density, readability, структура H2–H3;
- автоматический scorer (LLM-as-judge + rule-based): pass / revise / reject;
- negative examples в few-shot: «как не писать» для каждой ниши;
- документация для редакторов и версионирование промптов в Git.
Стек: промпт-дизайн, OpenAI/Claude API, Python (eval runner), Google Sheets, JSON Schema. Приёмка: 3 эталонных текста сверены с работой senior SEO.
Итог: правка черновика ~15–20 минут вместо 40–60; стабильность структуры и compliance в YMYL. NDA: домены клиента не публикуются.