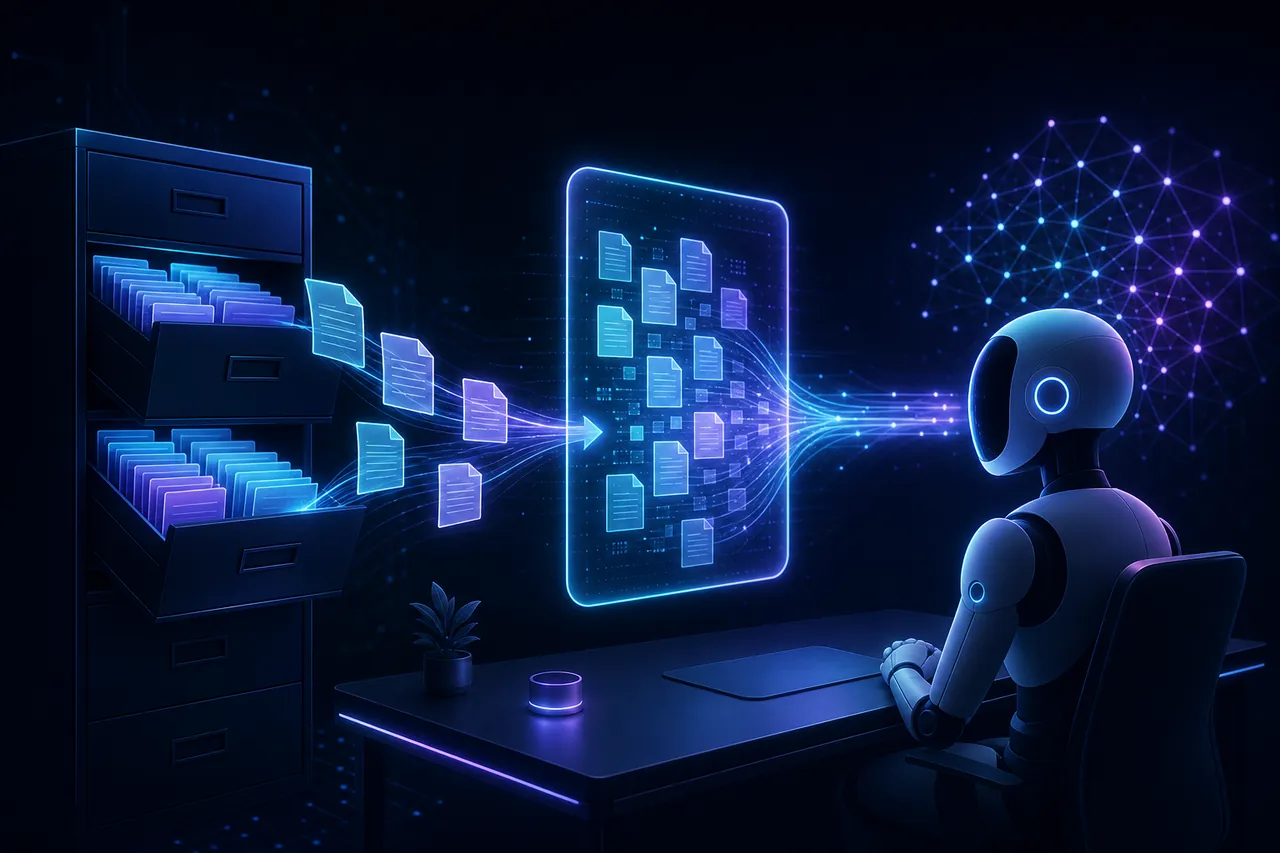
RAG — это схема, в которой перед ответом AI ищет нужные фрагменты в ваших данных и добавляет их в запрос.
Представьте сотрудника поддержки. Он не помнит все правила компании, но перед ответом открывает базу знаний, находит пару подходящих статей и формулирует ответ по ним.
Так же работает RAG:
— пользователь задаёт вопрос;
— система ищет релевантные куски документов;
— найденное передаётся модели вместе с вопросом;
— модель собирает ответ человеческим языком.
На практике это чат по документации, помощник для команды продаж, поиск по регламентам или бот, который отвечает по внутренней базе компании.
Главное ограничение: RAG не делает данные истинными. Если в базе устаревшая инструкция, поиск нашёл не тот фрагмент или важное правило разрезали при загрузке документа, модель уверенно соберёт плохой ответ.
Поэтому качество RAG начинается не с выбора модели, а с вопроса: может ли человек быстро найти в этих документах точный ответ? Если нет — AI тоже будет блуждать.