Python-скрипт: пакетная подготовка текстов перед публикацией
Папка черновиков → единый документ с чистыми заголовками за 1–2 минуты вместо 15–20.
CLI, Python, автоматизация
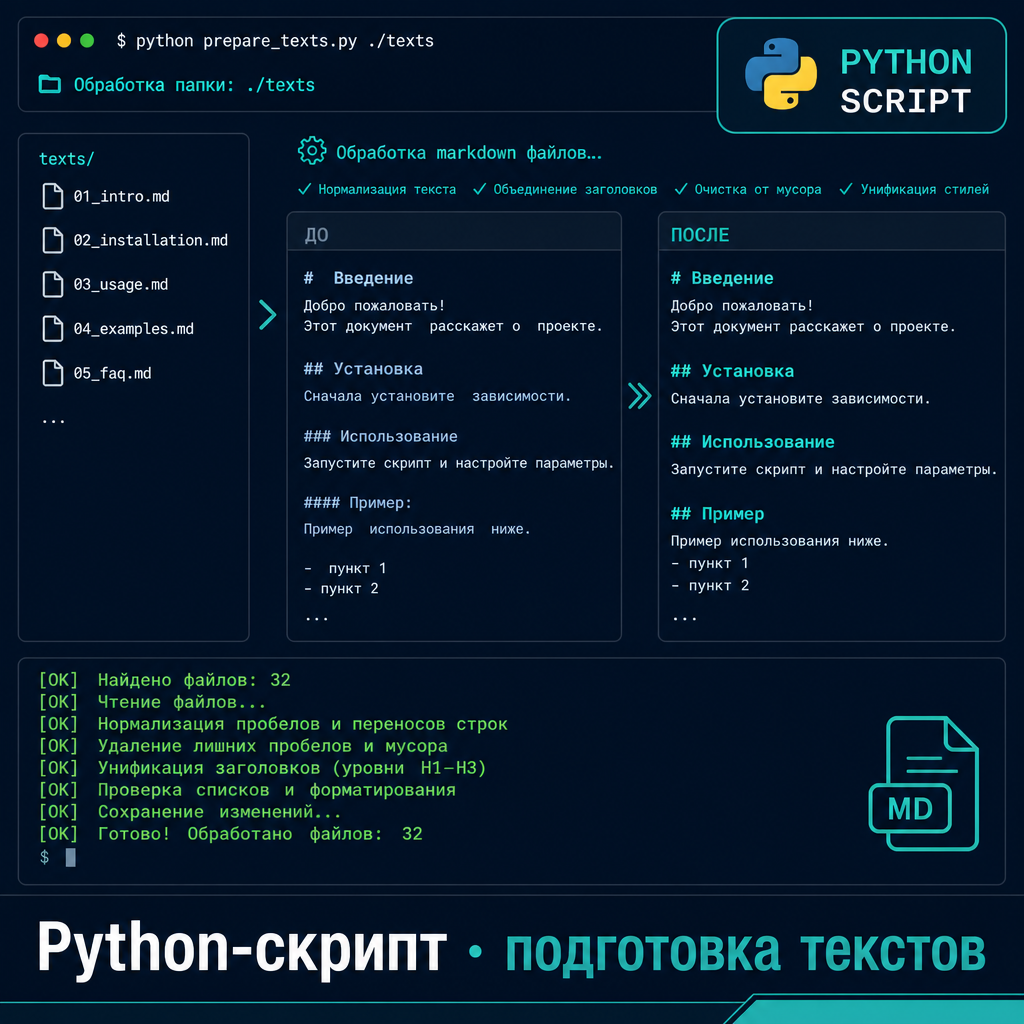
Клиент — контент-студия (SEO-тексты, 40+ авторов). Заготовки приходили в .txt и .md: разный регистр заголовков, неразрывные пробелы, «умные» кавычки, лишние дефисы. Редактор тратил 15–20 минут на ручную правку каждого файла перед заливкой в CMS.
Задача: консольный Python-скрипт — папка с исходниками → нормализация заголовков, очистка спецсимволов, один структурированный итоговый документ. Без GUI; пути и правила — в config.py.
- чтение всех .txt / .md из INPUT_DIR рекурсивно;
- распознавание заголовков: markdown (# ## ###) и «короткая строка + пустая строка»;
- HEADING_CASE: sentence / title — настройка в конфиге;
- очистка: NBSP, управляющие символы, повторные пробелы, типографский мусор;
- сборка OUTPUT.md с оглавлением и разделителями между исходниками;
- лог: сколько файлов обработано, warnings по нераспознанным заголовкам;
- CLI: python prepare.py [—dry-run].
Стек: Python 3.11, pathlib, regex, config.py, requirements.txt, README. Приёмка: 20 эталонных файлов «до/после» согласованы с редактором.
Итог: подготовка файла ~1–2 минуты вместо 15–20; единый стиль заголовков в потоке. NDA: студия не публикуется.